exec('docker run -d --name tenant-123 -p 3001:80 httpd:2.4', (error, stdout) => {
  if (error) {
    // 포트 충돌?? 이미지 없음?? 권한 문제??
  }
});
컨테이너를 띄우는 가장 단순한 방법은 docker run 한 줄을 쉘에서 부르는 것이다. 문제는 그 한 줄이 실패했을 때다. error 객체 하나로는 포트가 겹친 건지, 이미지가 없는 건지, 권한이 없는 건지 알 수 없다.
최근 IaaS(Infrastructure as a Service) 서비스를 직접 만들면서 이 문제를 정면으로 만났다. 사용자가 버튼을 누르면 그 사람 전용 컨테이너와 DB 스키마가 만들어지고, Google OAuth로 로그인한 본인만 거기에 접근할 수 있어야 했다. 이런 멀티 테넌트 프로비저닝에서는 컨테이너 하나를 띄우는 일보다 여러 사람이 동시에 요청하고 그중 일부가 중간에 실패하는 상황을 다루는 일이 훨씬 많다.
테넌트를 만드는 것보다 테넌트 생성이 실패했을 때 무엇을 치워야 하는지 아는 것이 어려웠다. 이 글에서는 쉘 스크립트 대신 Node.js의 Dockerode를 고른 이유와 DB를 스키마 단위로 나눈 결정, 인증과 롤백을 묶은 프로비저닝 흐름을 정리한다.
docker run 한 줄로는 실패의 종류를 알 수 없었다
처음에는 Bash 쉘 스크립트로 Docker CLI를 직접 호출하려 했다. 컨테이너 생성, 삭제, 상태 확인 정도라면 충분해 보였지만, 요구사항을 하나씩 붙일수록 스크립트가 불어났다.
컨테이너 생성이 실패하면 앞 단계에서 만든 것을 되돌려야 한다 (롤백).
이미 쓰고 있는 포트를 피해 새 포트를 골라야 한다 (포트 충돌 방지).
테넌트마다 메모리·CPU를 정해 줘야 한다 (동적 리소스 할당).
여러 사용자가 동시에 테넌트를 만들면 포트 번호나 컨테이너 이름이 겹칠 수 있다 (동시성).
네 가지 모두 “무엇이 실패했는지"를 코드가 알아야 풀리는 문제다. 쉘의 종료 코드와 stderr 문자열로는 그 분기를 안정적으로 짤 수 없었다.
Dockerode는 Docker Engine API를 Node.js에서 부르는 라이브러리다. 고른 이유는 두 가지다. 호출이 Promise를 돌려주니 await로 단계를 이어 붙일 수 있고, 실패가 예외로 올라오니 단계마다 따로 잡아서 처리할 수 있다.
// ❌ 기존 CLI 방식: 실패 원인을 구분할 수 없다
exec('docker run -d --name tenant-123 -p 3001:80 httpd:2.4', (error, stdout) => {
  if (error) {
    // 어떤 종류의 에러인지 파악 어려움..
    // 포트 충돌?? 이미지 없음?? 권한 문제??
  }
});

// ✓ Dockerode: 설정을 객체로 넘기고, 실패는 예외로 받는다
const container = await docker.createContainer({
  Image: 'httpd:2.4',
  name: `tenant-${tenantId}-${Date.now()}`,   // 이름 충돌을 피하려고 타임스탬프를 붙인다
  HostConfig: {
    PortBindings: { '80/tcp': [{ HostPort: port.toString() }] }
  }
});
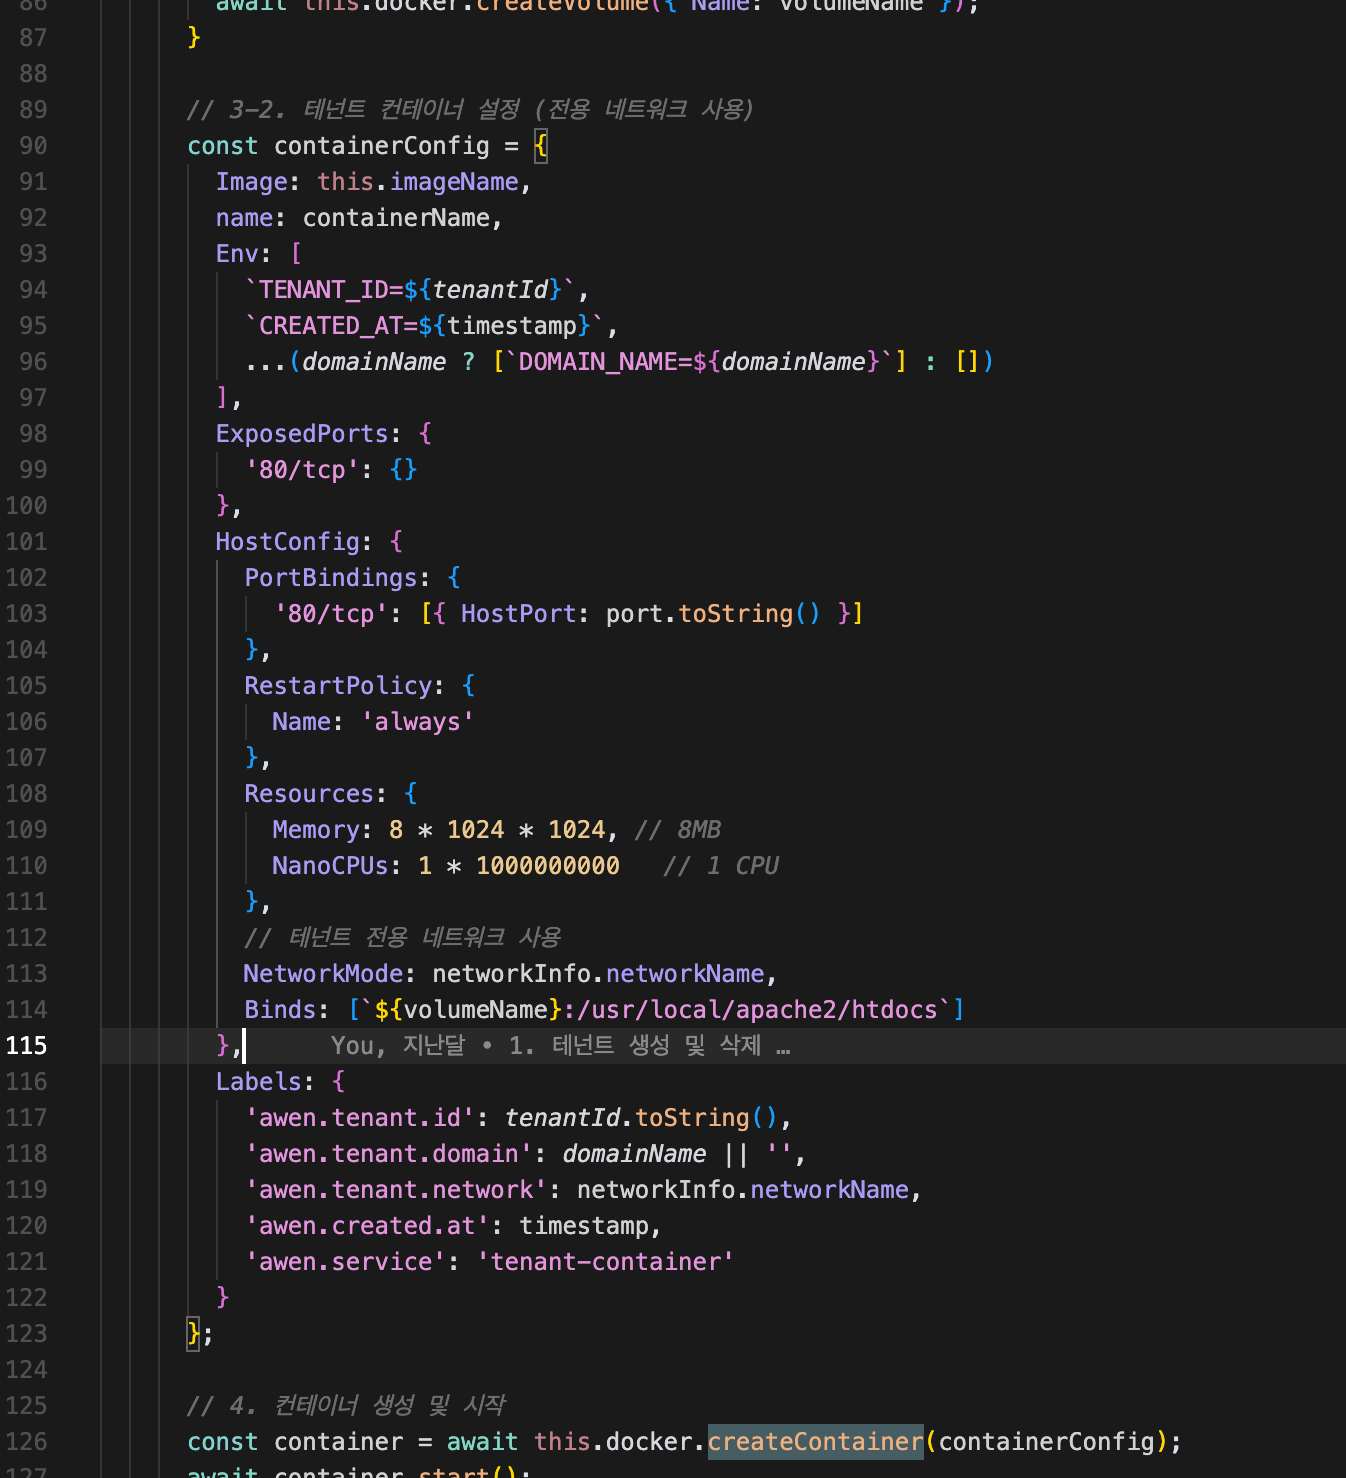
실제 설정은 위 예시보다 길다. 재시작 정책, 메모리와 CPU 제한, 테넌트 전용 네트워크, 볼륨, 테넌트 ID를 담은 Label까지 한 객체에 들어간다. 이걸 쉘 인자로 이어 붙였다면 따옴표 하나에 스크립트 전체가 흔들렸을 것이다.
Dockerode의 효용이 가장 컸던 곳은 포트 자동 할당이다. 사용 중인 포트를 실시간으로 확인하고 비어 있는 포트를 골라 붙이려면 Docker Engine API를 세밀하게 제어해야 했다. 목록 조회, 판단, 생성이 모두 같은 언어의 같은 흐름 안에 있어야 동시 요청 사이에서 포트가 겹치지 않게 다룰 수 있다.
테넌트마다 DB를 줄 수는 없었다: 스키마로 나눈 논리적 격리
멀티 테넌트 시스템에서 데이터 격리는 크게 두 방식으로 나뉜다.
| 구분 | 물리적 분리 | 논리적 분리 |
|---|---|---|
| 단위 | 테넌트마다 별도 DB 인스턴스 | 하나의 DB 안에서 스키마나 테이블로 분리 |
| 격리 수준 | 완벽한 격리 | DB 계정 권한에 기대는 격리 |
| 리소스 | 테넌트 수만큼 인스턴스 | 인스턴스 하나 |
격리 수준을 사려면 리소스를 내야 하고, 주어진 개발 환경에는 그 리소스가 없었다. 그래서 논리적 분리를 골랐다. 현실적인, 솔직히 말하면 쓰라린 선택이었다.
대신 스키마만 나누지 않고 테넌트 전용 DB 계정을 함께 만들고, 그 계정에는 자기 스키마에 대한 권한만 준다. 같은 인스턴스 안에 있어도 다른 테넌트의 스키마는 계정 수준에서 막힌다.
// 테넌트별 스키마 생성
async createTenantDatabaseSchema(tenantId, schemaName) {
  const dbUser = `tenant_${tenantId}`;
  const dbPassword = crypto.randomBytes(16).toString('hex');

  // 1. 스키마 생성
  await safeQuery(`CREATE SCHEMA IF NOT EXISTS ${schemaName}`);

  // 2. 전용 사용자 생성 및 권한 부여 (자기 스키마에만 ALL PRIVILEGES)
  await safeQuery(`CREATE USER '${dbUser}'@'%' IDENTIFIED BY '${dbPassword}'`);
  await safeQuery(`GRANT ALL PRIVILEGES ON ${schemaName}.* TO '${dbUser}'@'%'`);

  // 3. 기본 테이블 구조 생성
  await this.createTenantTables(schemaName);
}
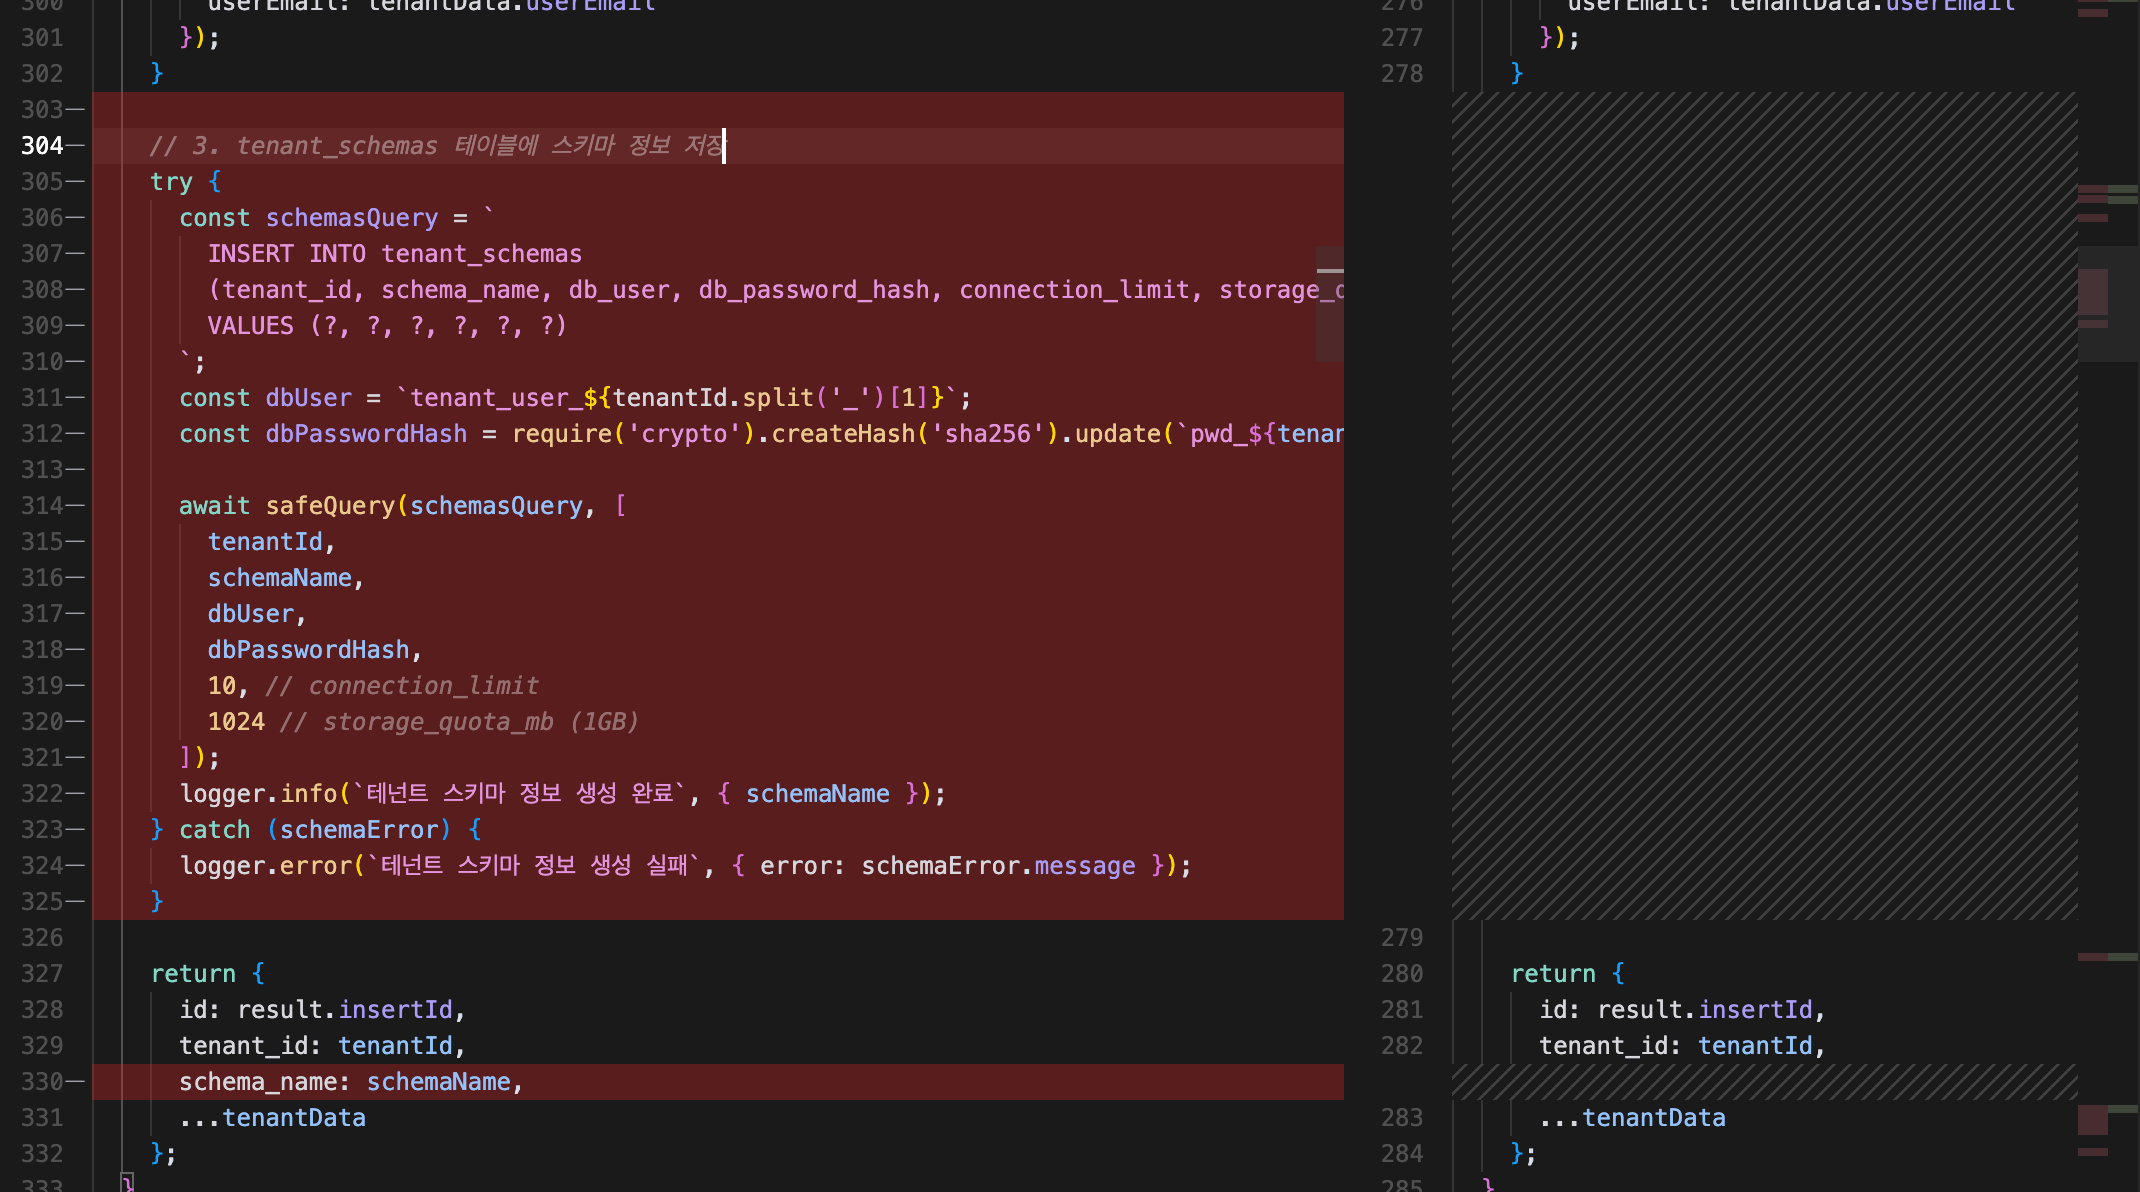
※ 결국 나중엔 제거 🤫
처음에는 테넌트별 스키마 정보를 tenant_schemas 테이블에 따로 기록했고, connection limit 10, storage quota 1GB 같은 값까지 넣었다. 결국 이 코드는 나중에 통째로 지웠다.
스키마를 나눈 다음에는 요청 단계에서도 막아야 한다. Google OAuth로 인증받은 사용자가 자기 테넌트에만 접근하도록 소유권을 확인하는 미들웨어를 붙였다.
// 테넌트 접근 제어 미들웨어
async verifyTenantAccess() {
  return async (req, res, next) => {
    const tenantId = req.params.tenantId;
    const userId = req.user.id;

    // 사용자-테넌트 소유권 확인
    const ownership = await this.getTenantOwnership(tenantId, userId);
    if (!ownership) {
      return res.status(403).json({ error: 'Access denied' });
    }

    next();
  };
}
DB 계정이 데이터를 막고, 미들웨어가 요청을 막는다. 논리적 분리의 약한 격리를 두 겹으로 메운 셈이다.
어디서 실패했느냐에 따라 치울 것이 달라진다
테넌트 하나를 만드는 과정은 다음 단계를 거친다.
사용자 인증 및 권한 확인
Docker 컨테이너 생성 및 포트 할당
데이터베이스 스키마 생성
메타데이터 저장 및 소유권 매핑
상태 확인 및 롤백 처리
각 단계가 실패할 수 있고, 실패한 시점마다 되돌릴 대상이 다르다. 예를 들어 컨테이너는 만들어졌는데 스키마 생성이 실패했다면, 이미 떠 있는 컨테이너를 정리해야 한다. 쉘 스크립트로 이 분기를 짜기 어려웠던 이유가 여기 있다.
flowchart LR
  A["인증·권한 확인"] --> B["컨테이너 생성·포트 할당"]
  B --> C["DB 스키마 생성"]
  C --> D["메타데이터·소유권 저장"]
  D --> E["상태 확인"]
  C -- 실패 --> R["생성된 컨테이너 정리"]
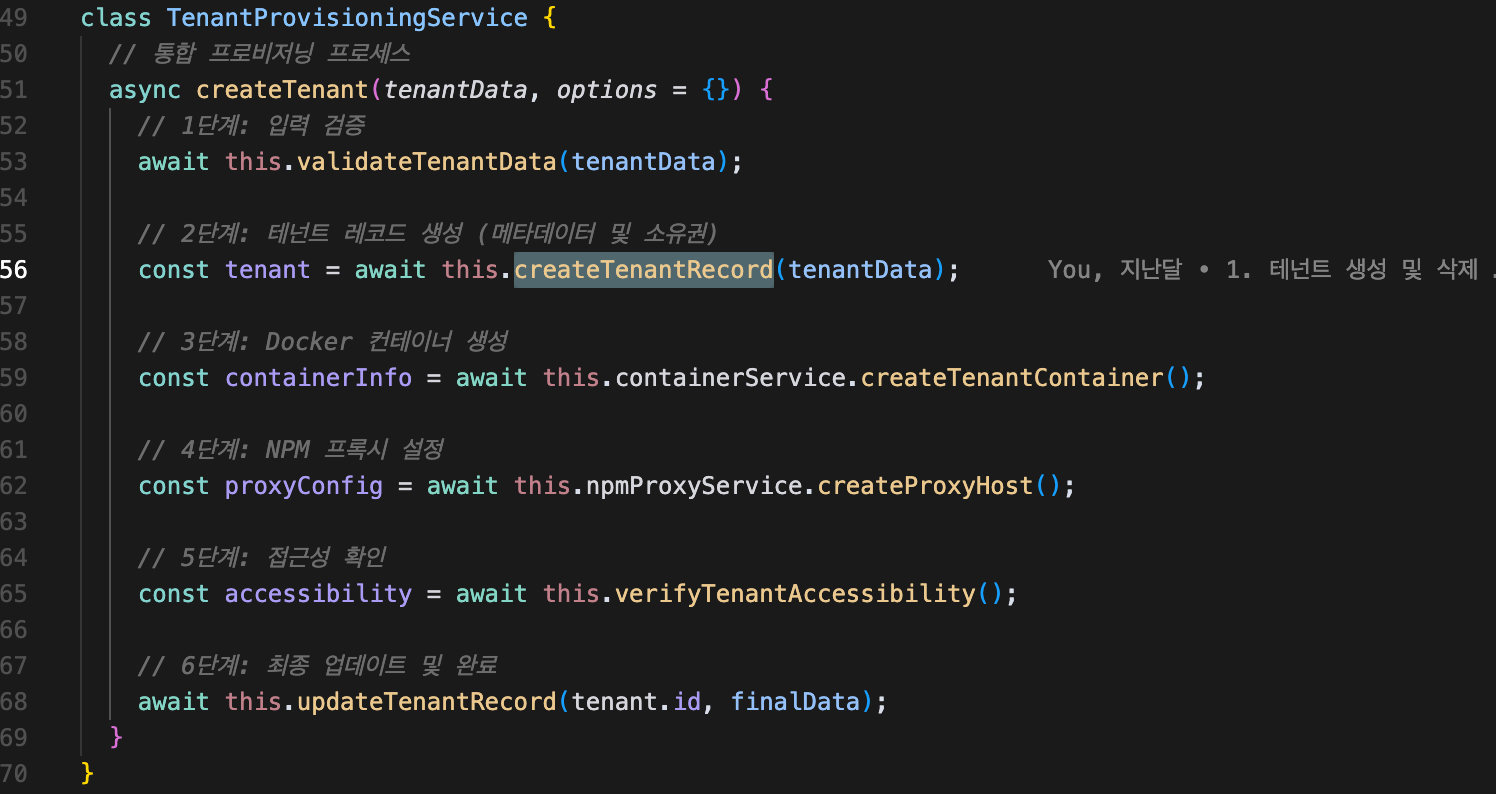
실제 createTenant는 입력 검증, 테넌트 레코드 생성, 컨테이너 생성, NPM(nginx-proxy-manager) 프록시 설정, 접근성 확인, 최종 업데이트의 6단계로 짜여 있다. 단계가 메서드 하나씩으로 나뉘어 있어서, 어느 await에서 예외가 났는지가 곧 롤백 범위가 된다.
30초에서 1분을 기다리게 하는 법
테넌트 생성은 오래 걸린다. 컨테이너 이미지 다운로드, DB 스키마 생성, 네트워크 설정이 순서대로 진행되면서 30초에서 1분 정도 걸린다. 그동안 사용자가 빈 화면만 보면 실패한 줄 안다.
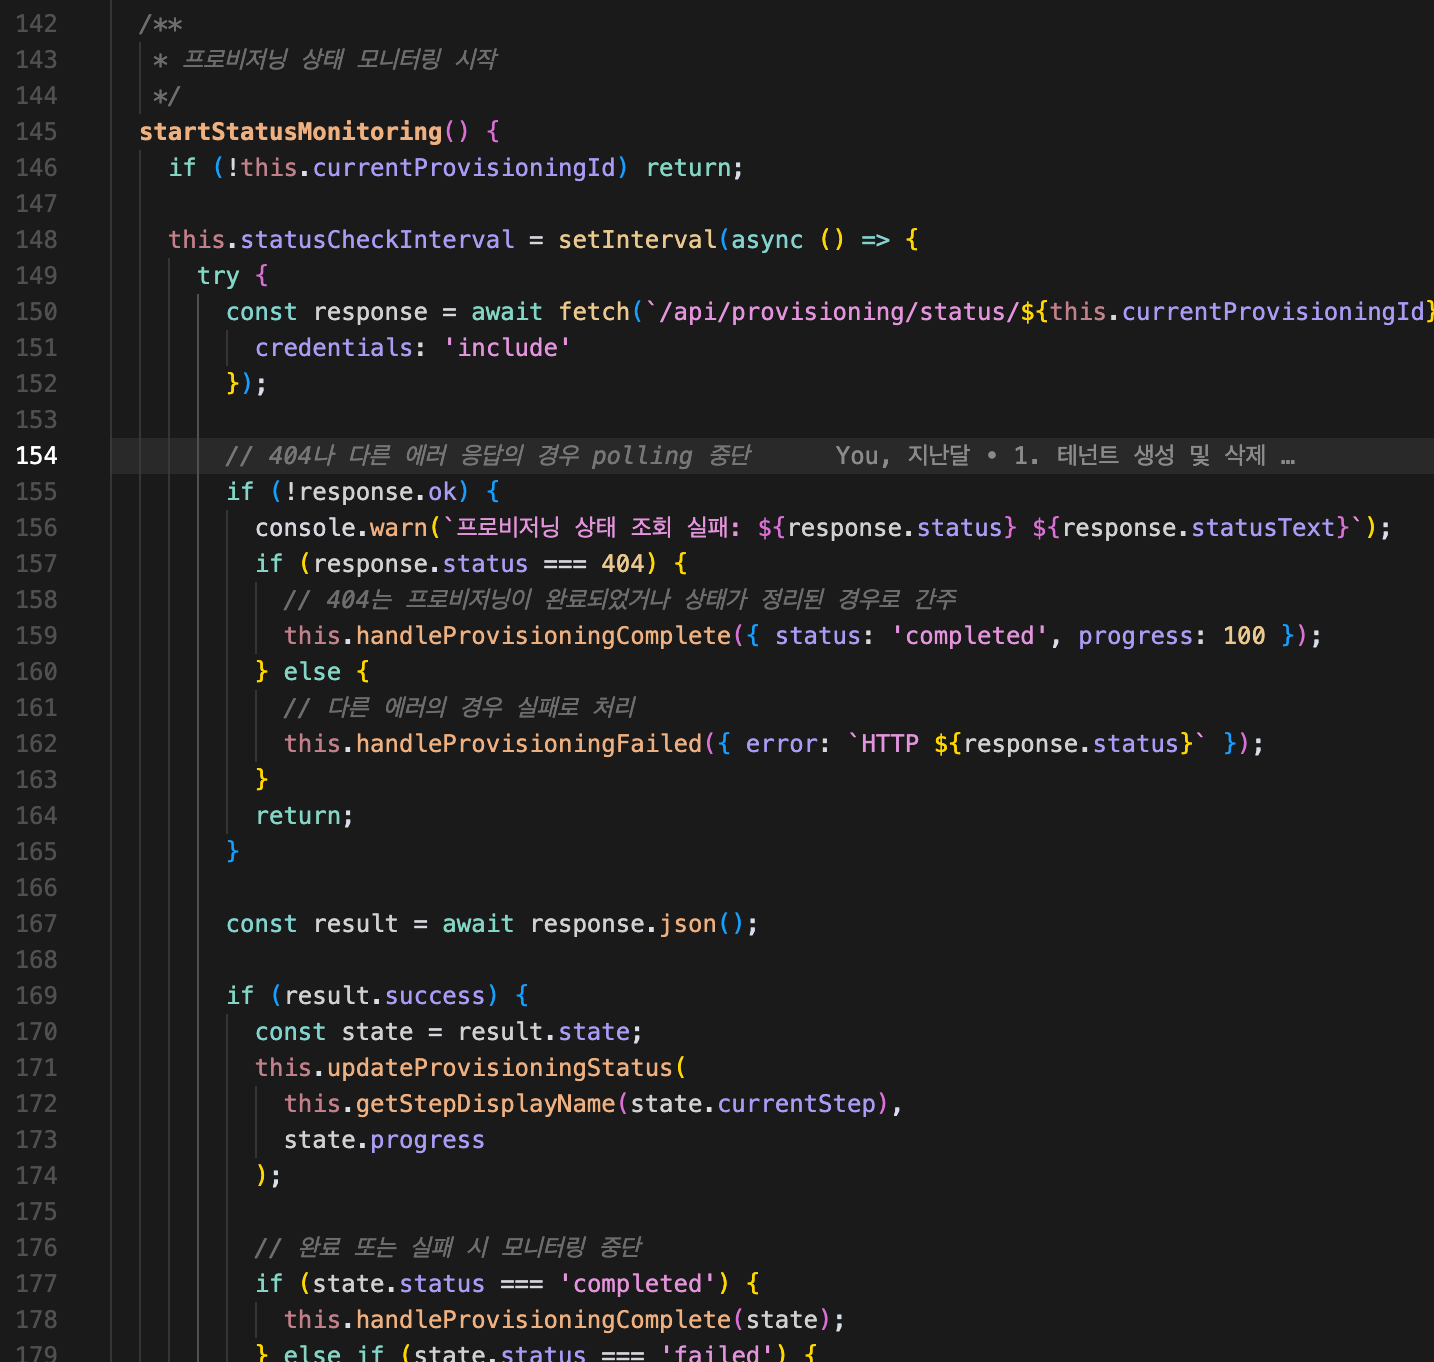
그래서 프로비저닝 상태 추적 시스템을 따로 만들었다. 서버는 현재 단계와 진행률을 기록하고, 프론트엔드는 WebSocket이나 폴링으로 그 상태를 받아 화면에 보여준다.
Node.js와 Google OAuth를 고른 이유
프로비저닝은 기다리는 시간이 대부분인 작업이다. Docker Engine API 응답을 기다리고, DB 쿼리를 기다린다. Node.js의 이벤트 루프 기반 비동기 처리는 이런 작업을 여러 개 동시에 걸어 두기에 맞았다. 특히 컨테이너 생성과 스키마 생성처럼 서로 의존하지 않는 작업은 Promise.all()로 동시에 실행해 전체 프로비저닝 시간을 줄였다.
인증은 자체 구현 대신 Google OAuth를 썼다. 자체 인증 시스템을 만들면 제어권은 더 갖지만, 비밀번호 저장과 세션 관리에서 생길 보안 취약점과 개발 복잡도를 함께 떠안는다. 테넌트 격리가 본업인 시스템에서 인증까지 직접 짤 이유는 없다고 봤다.
// Google OAuth 기반 사용자 정보 추출
passport.use(new GoogleStrategy({
  clientID: process.env.GOOGLE_CLIENT_ID,
  clientSecret: process.env.GOOGLE_CLIENT_SECRET,
  callbackURL: "/auth/google/callback"
}, async (accessToken, refreshToken, profile, done) => {
  const user = {
    id: profile.id,          // 테넌트 소유권 매핑에 쓰는 사용자 ID
    email: profile.emails[0].value,
    name: profile.displayName
  };
  return done(null, user);
}));
아직 남은 문제
지금 시스템은 단일 서버에서 돈다. 실제 서비스로 키우려면 풀어야 할 것이 남아 있다.
컨테이너 오케스트레이션. 서버가 한 대를 넘으면 포트 할당을 한 호스트 안에서 판단할 수 없다. Docker Swarm이나 Kubernetes로 넘어가야 한다.
데이터베이스 샤딩. 논리적 분리는 인스턴스 하나에 테넌트를 모두 싣는다. 테넌트 수가 늘면 그 인스턴스가 병목이 된다.
로드 밸런싱. nginx-proxy-manager로 트래픽을 나누는 구성이 필요하다.
모니터링. 테넌트별 리소스 사용량, 성능 지표, 오류 현황을 실시간으로 보는 체계가 없다. 다음 단계의 핵심이다.
스키마 이름은 쿼리에 문자열로 들어간다.
CREATE SCHEMA와GRANT의 식별자는 파라미터 바인딩을 할 수 없어서 템플릿 문자열로 넣었다.schemaName과tenantId가 사용자 입력에서 오지 않도록 앞단 검증에 기대고 있다.폴링은 404를 완료로 간주한다. 상태가 정리돼서 404가 났는지, 애초에 잘못된 ID라서 404가 났는지 프론트엔드는 구분하지 못한다.
정리
쉘 스크립트의 한계는 실패를 구분하지 못한다는 데 있었다. 롤백, 포트 충돌, 동시성은 모두 실패 원인을 알아야 풀린다.
Dockerode를 고른 이유는 Promise와 예외 두 가지다. 단계를
await로 잇고, 실패는 예외로 받아 단계별로 처리한다.격리는 리소스와 맞바꾼다. 물리적 분리 대신 스키마 분리를 택했고, 전용 DB 계정과 소유권 미들웨어로 약한 격리를 보강했다.
롤백 범위는 실패한 단계가 정한다. 프로비저닝을 단계별 메서드로 쪼개 두면 어디까지 치울지가 분명해진다.
오래 걸리는 작업은 진행 상태를 보여줘야 한다. 30초에서 1분이면 사용자는 기다리지 않는다.
멀티 테넌트 아키텍처는 개념으로는 한 문단이면 설명되지만, 막상 구현하면 포트 하나, 계정 하나, 실패 분기 하나마다 결정이 필요했다. 그중 몇 개는 벌써 지웠다.
이론과 실무의 거리는 그 지운 코드만큼이다.
참고자료
apocas/dockerode — Node.js용 Docker Remote API 클라이언트
Docker Engine API — 컨테이너 생성 옵션(HostConfig, PortBindings 등)의 원본 명세
MySQL CREATE USER Statement — 테넌트 전용 계정 생성 문법
passport-google-oauth20 — Passport의 Google OAuth 2.0 전략