배포 버튼을 누르면 서비스가 몇 초 동안 사라졌다. 타겟 그룹에 묶인 서버 전부에 같은 순간 JAR가 올라가고, 같은 순간 재시작됐기 때문이다. 파이프라인은 SSH_SERVERS 목록을 반복문으로 돌 뿐, 서버 하나가 재시작하는 동안 나머지가 트래픽을 받아준다는 개념이 없었다.
운영 환경을 살펴보니 이런 단일 타겟 그룹으로 돌아가는 서비스가 생각보다 많았다. 서버가 두 대 이상인데도 배포 순간에는 한 대짜리와 다를 게 없었다. 서버 수는 가용성을 위해 늘려 놓은 것인데, 배포 방식이 그 가용성을 매번 지워 버리고 있었다.
배포는 빨라야 하는 게 아니라 끊기지 않아야 한다. 이 글에서는 동시 배포 파이프라인을 Rolling Deployment로 바꾸며 내린 네 가지 결정을 정리한다. 서버별 순차 배포와 Load Balancer 제어를 묶는 방식이다. 순서, LB 제어, 승인 모드, 실패 처리 순이다.
동시 배포는 빠르기 때문에 오래 살아남았다
기존 파이프라인의 배포 스테이지는 이렇게 생겼다. Publish Over SSH 플러그인으로 서버 목록을 순회하며 파일을 올리고 execCommand로 재시작한다.
stage('App. SSH Deploy') {
  when {
    expression { env.ONLY_BUILD != 'true' }
  }
  steps([$class: 'BapSshPromotionPublisherPlugin']) {
    script {
      targets = env.SSH_SERVERS.split(',')
      targets.each { server ->
        echo "TARGET SSH SERVER : ${server}"
        sshPublisher(
          continueOnError: false, failOnError: true,
          publishers: [
            sshPublisherDesc(
              configName: server,
              verbose: true,
              transfers: [
                sshTransfer(sourceFiles: env.SSH_SOURCE_FILES,
                  removePrefix: env.SSH_REMOVE_REFIX,
                  remoteDirectory: env.SSH_REMOTE_DIRECTORY,
                  execCommand: env.SSH_EXEC_COMMAND)
              ]
            )
          ]
        )
      }
    }
  }
}
반복문이 있으니 얼핏 순차 배포처럼 보인다. 하지만 서버 사이에 아무 대기도 없고 LB는 이 서버가 지금 재시작 중이라는 사실을 모른다. 모든 서버가 거의 동시에 내려갔다 올라오고, 그 사이 요청은 죽은 포트로 흘러간다. 문제는 배포가 느린 게 아니라 LB가 배포를 모른다는 것이다.
이 구조가 오래 남아 있던 이유는 단순하다. 빠르고, 코드가 짧고, 서버가 한 대일 때는 아무 차이가 없다. 서버가 늘어난 뒤에도 파이프라인은 그대로였다.
무중단을 위해 정한 네 가지 요구사항
Rolling Deployment로 바꾸면서 요구사항을 넷으로 정리했다. 요구사항 하나가 곧 설계 결정이었다.
서버별 순차 배포. 한 번에 한 서버만 배포한다. 배포 시간은 서버 수에 비례해 늘어나지만, 그 대가로 배포 중에도 항상 N-1대가 살아 있다.
Load Balancer 제어. 배포 대상 서버를 LB에서 먼저 빼고, 배포가 끝나면 다시 넣는다. 순차 배포만으로는 부족하다. LB가 모르는 순차 배포는 죽은 서버로도 요청을 보낸다.
승인 단계 제어. 승인 절차를 파라미터로 켜고 끈다. 개발 환경은 승인이 필요 없고, 운영 환경은 서버마다 확인이 필요하다. 이 파이프라인은 여러 Business Partner가 같이 쓰기 때문에 환경별로 다른 파이프라인을 만드는 대신 하나에 옵션을 열어 두기로 했다.
실패 시 복구. 배포 도중 예외가 나면 그 서버를 LB에 되돌려 놓고 파이프라인을 멈춘다.
승인 단계에는 Choice Parameter로 세 가지 모드를 뒀다.
First server only: 첫 번째 서버만 승인한다. 첫 서버를 LB에서 빼고 배포한 뒤 파이프라인을 멈추고 담당자가 검증한다. Proceed면 LB에 재등록하고 나머지 서버는 승인 없이 이어서 배포한다. Abort면 배포를 중단하고 그 서버를 LB에 재등록한다.All servers: 같은 흐름을 모든 서버에 적용한다. 서버마다 검증과 승인이 들어간다.Verification Pass: 승인 단계를 전부 생략하고 자동으로 진행한다.
서버를 하나씩 LB에서 빼면 왜 끊기지 않는가
원리는 한 문단이면 된다. LB에서 deregister된 서버는 새 요청을 받지 않으니, 그 서버가 JAR를 교체하고 재시작하는 동안 트래픽은 나머지 서버로 간다. 재시작이 끝나면 register해서 다시 트래픽을 받게 하고 그다음 서버로 넘어간다. 어느 순간에도 LB에 등록된 서버 중 재시작 중인 서버는 없다. 이것이 무중단의 전부다.
sequenceDiagram
    participant J as Jenkins
    participant LB as Load Balancer
    participant S1 as Server 1
    participant S2 as Server 2
    J->>LB: deregister S1
    Note over LB,S2: 트래픽은 S2로만 간다
    J->>S1: JAR 배포, 재시작
    J-->>J: (승인 모드에 따라) input 대기
    J->>LB: register S1
    J->>LB: deregister S2
    Note over LB,S1: 트래픽은 S1로만 간다
    J->>S2: JAR 배포, 재시작
    J->>LB: register S2
단, 이 원리는 “deregister 직후 그 서버로 가던 요청이 다 끝났다"와 “register 직전 애플리케이션이 실제로 떠 있다"를 전제한다. 파이프라인은 둘 다 보장하지 않는다. 이 이야기는 뒤에서 다시 한다.
파이프라인을 어떻게 바꿨나
승인 모드 파라미터
기존 파라미터에 INPUT_APPROVAL_MODE를 추가했다. 값은 위의 세 문자열이다.
parameters {
  // 기존 파라미터들...
  choice(name: 'INPUT_APPROVAL_MODE',
    choices: ['First server only', 'All servers', 'Verification Pass'],
    description: ''
  )
}
LB 제어 스크립트 경로
LB를 빼고 넣는 실제 동작은 각 서버에 있는 쉘 스크립트에 맡기고 파이프라인은 경로만 환경변수로 안다. 기본값을 두어 환경변수가 없어도 돌아가게 했다.
environment {
  // 기존 환경변수들...
  INPUT_APPROVAL_MODE = "${params.INPUT_APPROVAL_MODE}"
  LB_DEREGISTER_SCRIPT = "${env.LB_DEREGISTER_SCRIPT ?: 'lb_deregister.sh'}"
  LB_REGISTER_SCRIPT = "${env.LB_REGISTER_SCRIPT ?: 'lb_register.sh'}"
}
LB 종류를 파이프라인에서 분리한 것이 이 설계의 두 번째 결정이다. ALB든 NGINX upstream이든 HAProxy든, 파이프라인은 script server action 형태로 호출만 하고 내용은 서버 쪽 스크립트가 책임진다.
Rolling Deploy 스테이지
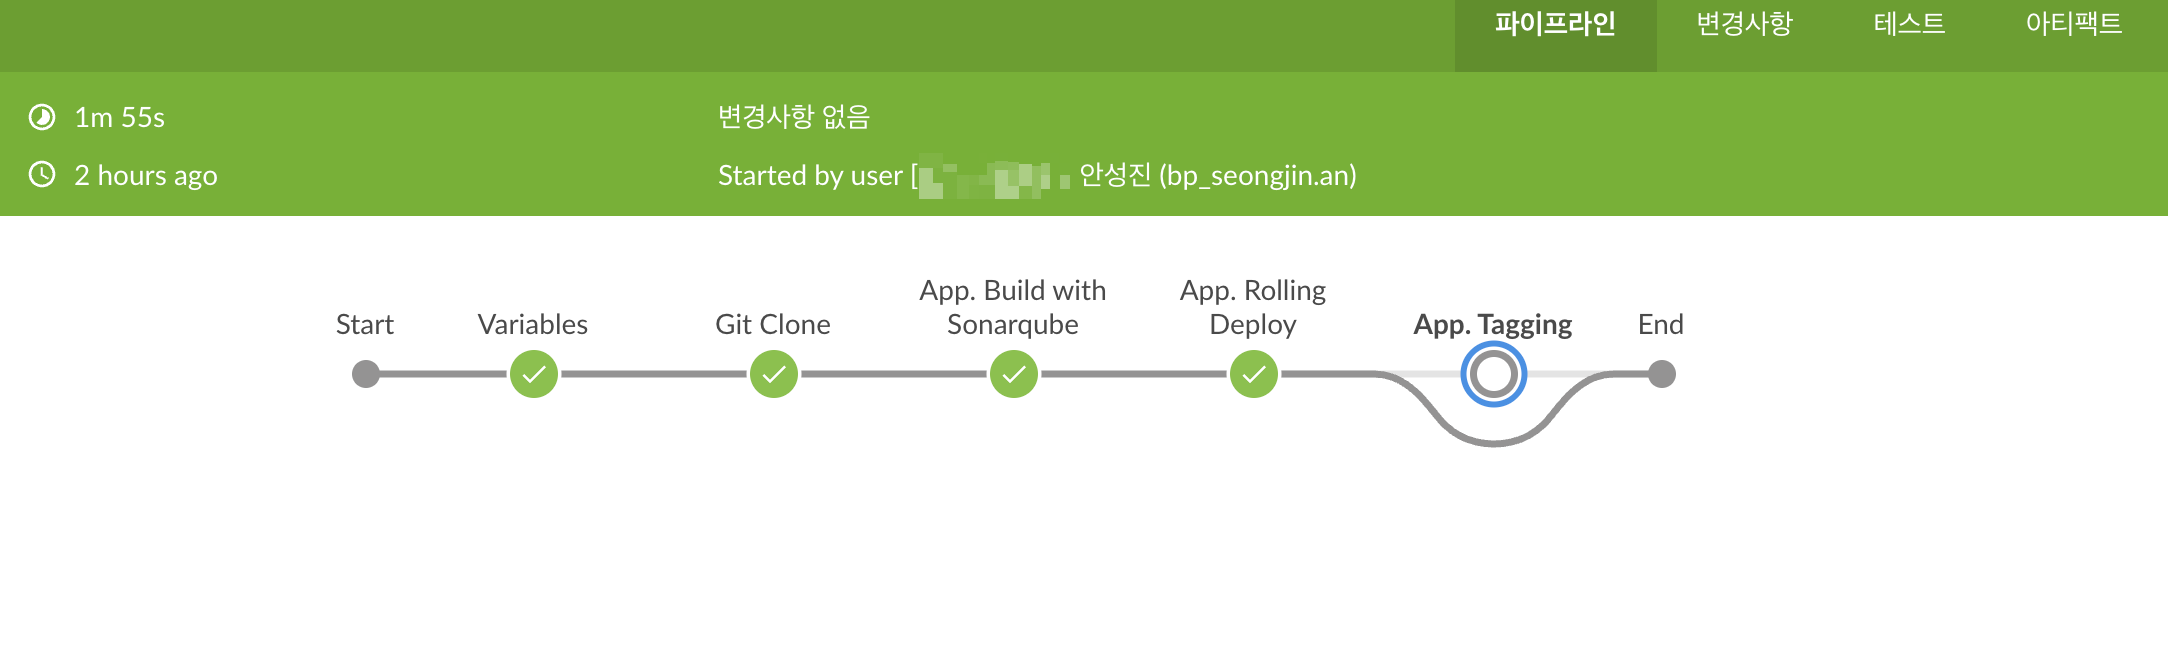
기존 App. SSH Deploy 스테이지를 통째로 교체했다. 서버마다 deregister, 배포, 조건부 승인, register 네 단계를 돌고 예외가 나면 catch에서 register를 다시 시도한 뒤 파이프라인을 멈춘다.
stage('App. Rolling Deploy') {
  when {
    expression { env.ONLY_BUILD != 'true' }
  }
  steps {
    script {
      def servers = env.SSH_SERVERS.split(',')
      def serverCount = servers.size()

      echo "Starting Rolling Deployment to ${serverCount} servers..."
      echo "Input Approval Mode: ${env.INPUT_APPROVAL_MODE}"

      servers.eachWithIndex { server, index ->
        def currentServerIndex = index + 1
        echo "=========================================="
        echo "배포 시작 ${currentServerIndex}/${serverCount}: ${server}"
        echo "=========================================="

        try {
          // 1. 배포 전에 LB에서 뺀다. 이 서버로는 새 요청이 오지 않는다
          echo "[Step 1] 로드 밸런서에서 ${server} 서버 등록 해제"
          executeLBScript(server, env.LB_DEREGISTER_SCRIPT, "deregister")

          // 2. JAR 배포 및 재시작. 기존 SSH Deploy와 같은 동작
          echo "[Step 2] ${server} 서버에 애플리케이션 배포 시작"
          deployToServer(server)

          // 3. 승인 모드에 따라 여기서 멈춘다. 서버는 아직 LB 밖이다
          if (shouldRequireInput(currentServerIndex, env.INPUT_APPROVAL_MODE)) {
            echo "[Step 3] ${server} 서버 배포 정상여부 확인 및 승인 대기"
            def approvalMessage = """
            🔄 배포 완료 진행률 ${currentServerIndex}/${serverCount} (${server})

            애플리케이션이 올바르게 작동하는지 확인하세요:
            • 애플리케이션 로그 확인
            • 서비스 상태 확인
            • 중요 기능 테스트

            'Proceed'을 클릭하여 서버를 로드 밸런서에 다시 등록하고 다음 서버로 계속 진행합니다.
            """

            input(
              message: approvalMessage,
              ok: 'Proceed',
              submitterParameter: 'APPROVER'
            )

            // echo "Deployment verification approved by: ${env.APPROVER}"
            echo "승인자: ${currentBuild.getBuildCauses('hudson.model.Cause$UserIdCause')[0]?.userId ?: 'Unknown'}"
          } else {
            echo "[Step 3] ${server} 서버 승인 건너뛰기 (mode: ${env.INPUT_APPROVAL_MODE})"
          }

          // 4. 검증이 끝난 뒤에야 LB에 되돌린다
          echo "[Step 4] ${server} 서버 로드밸런서에 다시 등록"
          executeLBScript(server, env.LB_REGISTER_SCRIPT, "register")

          echo "Server ${currentServerIndex}/${serverCount} (${server}) deployment completed successfully!"

        } catch (Exception e) {
          echo "❌ ${server} 서버에 배포하는 동안 오류가 발생했습니다. (${e.getMessage()})"

          try {
            // 실패한 서버를 LB 밖에 남겨 두지 않는다. Abort도 여기로 들어온다
            echo "🔄 ${server} 서버 로드밸런서에 다시 등록"
            executeLBScript(server, env.LB_REGISTER_SCRIPT, "register")
          } catch (Exception rollbackError) {
            echo "❌ Rollback failed: ${rollbackError.getMessage()}"
          }

          error "${server} 서버 배포 실패"
        }
      }

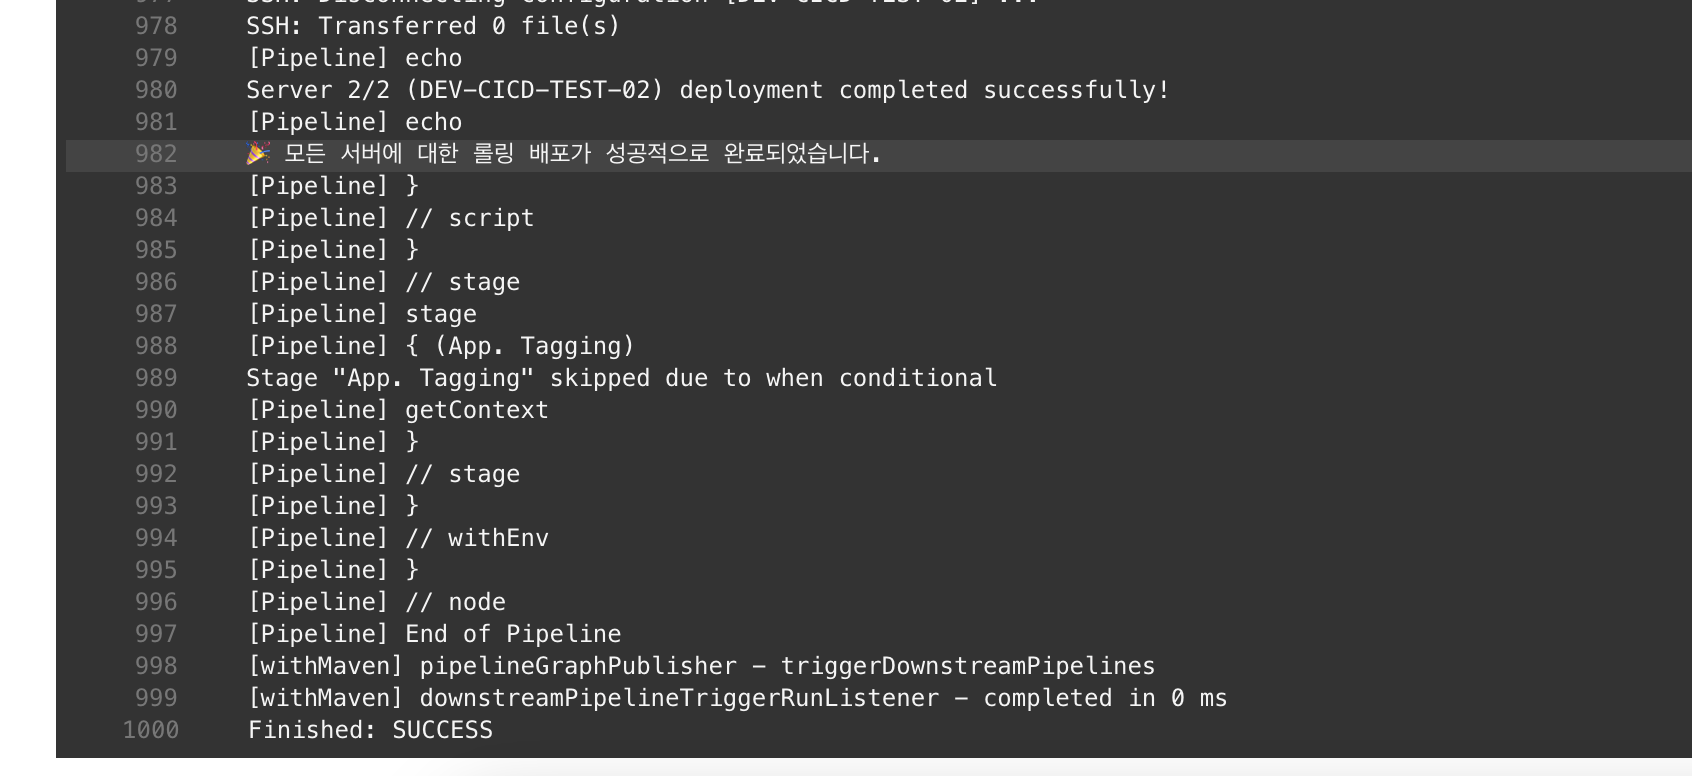
      echo "🎉 모든 서버에 대한 롤링 배포가 성공적으로 완료되었습니다."
    }
  }
}
승인은 배포 뒤, 재등록 전에 온다. 담당자는 LB 밖에 있는 서버를 직접 붙어 확인하고 Proceed를 눌러야만 그 서버가 트래픽을 받는다. Abort를 누르면 input이 예외를 던지고 catch로 들어가 서버가 LB에 되돌아간다. 이 순서 덕분에 검증 중인 서버가 사용자 트래픽을 받는 일이 없다.
지원 함수
승인 여부 판단, LB 스크립트 실행, 배포를 함수로 뺐다. executeLBScript와 deployToServer는 둘 다 sshPublisher를 쓴다. 다만 executeLBScript는 파일 전송 없이 execCommand만 보낸다.
def shouldRequireInput(serverIndex, inputMode) {
  switch(inputMode) {
    case 'First server only':
      return serverIndex == 1
    case 'All servers':
      return true
    case 'Verification Pass':
      return false
    default:
      return false
  }
}

def executeLBScript(server, script, action) {
  sshPublisher(
    continueOnError: false, failOnError: true,
    publishers: [
      sshPublisherDesc(
        configName: server,
        verbose: true,
        transfers: [
          sshTransfer(execCommand: "${script} ${server} ${action}")
        ]
      )
    ]
  )
}

def deployToServer(server) {
  sshPublisher(
    continueOnError: false, failOnError: true,
    publishers: [
      sshPublisherDesc(
        configName: server,
        verbose: true,
        transfers: [
          sshTransfer(
            sourceFiles: env.SSH_SOURCE_FILES,
            removePrefix: env.SSH_REMOVE_REFIX,
            remoteDirectory: env.SSH_REMOTE_DIRECTORY,
            execCommand: env.SSH_EXEC_COMMAND
          )
        ]
      )
    ]
  )
}
서버 쪽 LB 스크립트
파이프라인이 호출하는 스크립트는 각 서버에 미리 둔다. 원문 그대로 껍데기만 있다. 실제 LB API 호출은 환경마다 채워야 한다.
#!/bin/bash
# lb_deregister.sh
SERVER_NAME=$1
ACTION=$2
echo "Deregistering server $SERVER_NAME from Load Balancer..."
# AWS ALB, NGINX Upstream, HAProxy 등 실제 LB API 호출

#!/bin/bash
# lb_register.sh
SERVER_NAME=$1
ACTION=$2
echo "Registering server $SERVER_NAME to Load Balancer..."
# AWS ALB, NGINX Upstream, HAProxy 등 실제 LB API 호출
환경마다 승인 모드가 달라진다
승인 모드를 파라미터로 열어 둔 이유가 여기서 드러난다. 파이프라인 하나가 세 환경을 덮는다.
개발 환경. 승인 모드 Verification Pass
# 승인 절차 없이 자동 배포
Server 1: LB 해제 → 배포 → LB 등록
Server 2: LB 해제 → 배포 → LB 등록
Server 3: LB 해제 → 배포 → LB 등록
스테이징 환경. 승인 모드 First server only
# 첫 번째 서버만 승인 절차 적용
Server 1: LB 해제 → 배포 → [승인 대기] → LB 등록
Server 2: LB 해제 → 배포 → LB 등록
Server 3: LB 해제 → 배포 → LB 등록
운영 환경. 승인 모드 All servers
# 모든 서버에 승인 절차 적용
Server 1: LB 해제 → 배포 → [승인 대기] → LB 등록
Server 2: LB 해제 → 배포 → [승인 대기] → LB 등록
Server 3: LB 해제 → 배포 → [승인 대기] → LB 등록
First server only가 실질적인 Canary 역할을 한다. 첫 서버에서 문제가 보이면 Abort 한 번으로 나머지 서버는 손대지 않은 채 멈춘다.
바뀐 것과 바뀌지 않은 것
| 구분 | 기존 방식 | Rolling Deployment |
|---|---|---|
| 배포 방식 | 전체 서버 동시 배포 | 서버별 순차 배포 |
| 서비스 가용성 | 배포 중 서비스 중단 | 무중단 배포 |
| 문제 발생 시 | 전체 서비스 영향 | 단일 서버 영향 |
| 승인 절차 | 없음 | 파라미터로 제어 |
| 롤백 | 수동 처리 | 자동 롤백 시도 |
표의 마지막 줄 “자동 롤백 시도"는 코드의 catch 블록에서 LB 재등록 하나뿐이다. 이전 JAR로 되돌리지는 않는다.
정리
무중단의 핵심은 순서다. 서버를 하나씩 LB에서 빼고, 올리고, 검증하고, 다시 넣는다. 어느 순간에도 LB에 등록된 서버 중 재시작 중인 서버는 없다.
LB가 모르는 순차 배포는 무중단이 아니다. 반복문만으로는 부족하고, deregister와 register가 배포를 감싸야 한다.
승인은 환경마다 다르게 필요하다. 첫 서버만, 전부, 생략 세 가지를 파라미터로 열어 두면 파이프라인 하나로 개발, 스테이징, 운영을 다 덮는다.
승인은 배포 뒤, 재등록 전에 둔다. 검증 중인 서버가 트래픽을 받지 않게 하는 위치다.
롤백이라 부르지만 아직은 LB 재등록뿐이다. 헬스체크와 이전 JAR 복원은 다음 과제다.
LB 제어 스크립트는 껍데기다. ALB든 NGINX upstream이든 실제 API 호출은 각자 채워야 한다.
동시 배포는 빠르다. 그래서 오래 남아 있었다. 바꾸고 나니 배포 시간은 서버 수만큼 늘었고, 대신 배포 중에 서비스가 사라지는 일은 없어졌다. 서버를 여러 대 두는 이유가 가용성이라면, 배포도 그 가용성을 존중해야 한다.
느린 배포가 끊기는 배포보다 낫다.
참고자료
Pipeline: Input Step —
input스텝의submitterParameter,ok, 반환값 설명Publish Over SSH Plugin —
sshPublisher,sshTransfer의execCommand와sourceFiles옵션Pipeline Syntax —
parameters,environment,when블록의 선언적 문법Target groups for your Application Load Balancers — ALB 타겟 등록·해제와 deregistration delay